
Einleitung
Vorausschauende Wartung ist ein überzeugendes Versprechen: Die Maschine meldet den Ausfall, bevor er eintritt. Statt Stillstand im laufenden Auftrag ein geplanter Eingriff in der Wartungsschicht.
In einer Druckerei mit Mehrschichtbetrieb ist das ein hoher Wert. Ein unvorhergesehener Stillstand an der Druckmaschine kostet nicht nur die Stillstandszeit, sondern auch Makulatur, Rüstzeit für den Wiederanlauf und häufig einen Termin beim Kunden.
Entsprechend attraktiv sind Angebote zur Sensorik, Zustandsüberwachung und datenbasierten Ausfallvorhersage.
Bevor investiert wird, lohnt eine unbequeme Frage: Auf welcher Datenbasis soll ein Modell lernen?
In den meisten mittelständischen Druckereien lautet die ehrliche Antwort: Es gibt keine. Nicht, weil nicht dokumentiert würde – sondern weil die Dokumentation für diesen Zweck nicht verwertbar ist.
Das ist keine Absage an vorausschauende Wartung. Es ist eine Aussage über die Reihenfolge.
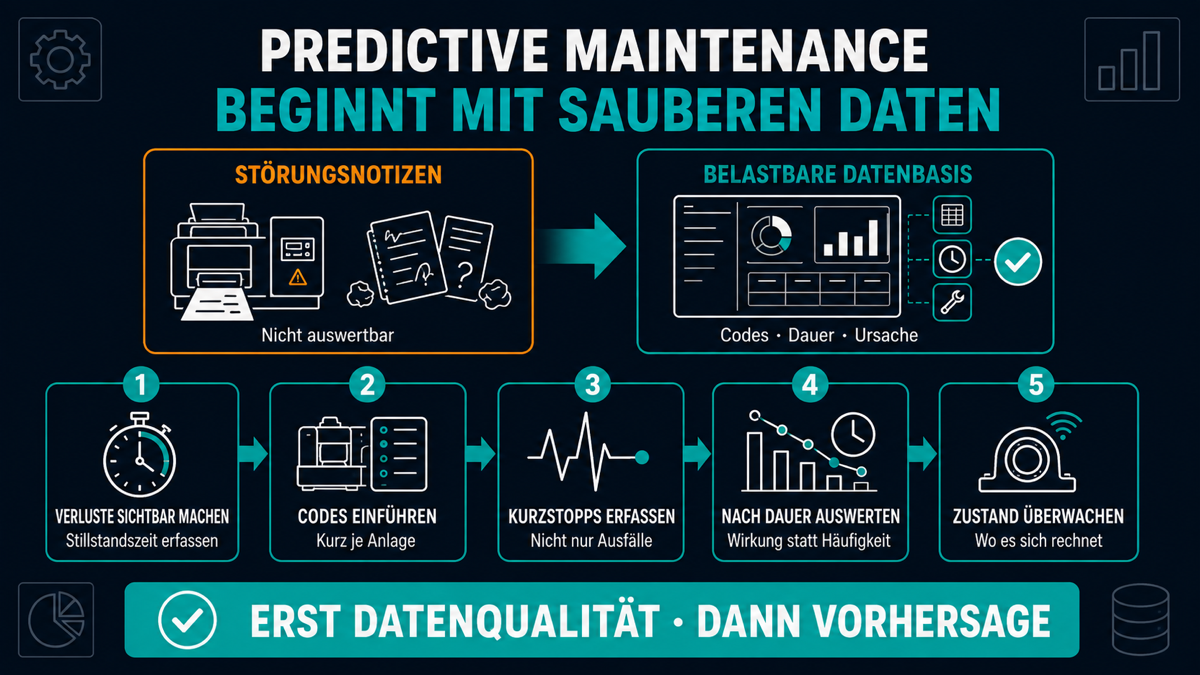
Das Problem: Störungen werden dokumentiert, aber nicht auswertbar erfasst
Fast jede Druckerei führt ein Schichtbuch oder Störungsprotokoll. Die Einträge sehen typischerweise so aus:
- „Passer nicht stabil, nachgestellt“
- „Anleger Störung, behoben“
- „Farbwerk gereinigt, lief wieder“
- „Auslage klemmt, Techniker war da“
Diese Einträge sind fachlich korrekt und für die nächste Schicht nützlich. Für eine Auswertung sind sie unbrauchbar – aus drei Gründen.
Erstens sind sie Freitext. Dieselbe Störung wird von fünf Personen unterschiedlich beschrieben. Eine Häufigkeitsanalyse ist damit nicht möglich.
Zweitens fehlt die Dauer. Ohne Stillstandszeit lässt sich nicht unterscheiden, ob eine Störung achtmal je zwei Minuten oder einmal drei Stunden gekostet hat.
Drittens fehlt die Zuordnung zur Baugruppe. Ohne diese Zuordnung ist keine Aussage darüber möglich, welches Bauteil auffällig ist.
Ein Vorhersagemodell benötigt genau das: gleich benannte Ereignisse, mit Zeitpunkt, Dauer und Bezug zu einer Baugruppe, über einen ausreichend langen Zeitraum und mit einer relevanten Zahl an Ausfällen desselben Typs.
Auffällig ist dabei: Kaum eine Druckerei kann sagen, welche drei Störungsarten im letzten Jahr die meiste Stillstandszeit verursacht haben. Das ist die Frage, die vor jeder Investition zu beantworten ist – und sie braucht keine Sensorik.
Ursachen: Warum die Datenbasis fehlt
Erfassung dient der Schichtübergabe, nicht der Analyse
Das Schichtbuch wurde für die Kommunikation zwischen Schichten geschaffen. Für diesen Zweck ist Freitext richtig. Für Auswertung nicht.
Es gibt keine Störungscodes
Ohne eine kurze, verbindliche Auswahlliste je Anlage entsteht keine Vergleichbarkeit. Wird die Liste zu lang, wird sie nicht genutzt.
Kurzstillstände werden nicht erfasst
Stopps unter fünf Minuten gelten als normaler Betrieb. In der Summe machen sie häufig den größeren Teil der Verluste aus als die seltenen langen Ausfälle.
Ursache und Symptom werden vermischt
„Papierstau“ ist ein Symptom. Die Ursache kann Feuchte, Schnittqualität, Anlegereinstellung oder ein verschlissenes Bauteil sein. Ohne diese Trennung ist keine Maßnahme ableitbar.
Die Maschinendaten sind vorhanden, aber nicht zugänglich
Moderne Anlagen erfassen intern erhebliche Datenmengen. Ob und wie diese exportierbar sind, ist eine Frage der Schnittstellen und der Herstellervereinbarung – und sollte vor jedem Vorhaben geklärt werden.
Verschleißteile werden nicht nachverfolgt
Ohne Zuordnung von Wechseln zu Baugruppe und Laufleistung gibt es keine Standzeitdaten. Genau die wären die Grundlage jeder Vorhersage.
Ausfälle desselben Typs sind selten
Das ist der Punkt, der die meisten Vorhaben scheitern lässt: Für ein belastbares Modell braucht es eine ausreichende Zahl vergleichbarer Ausfälle. Bei einer einzelnen Anlage mit wenigen Ausfällen pro Jahr ist diese Bedingung schwer erfüllbar – unabhängig vom Verfahren.
Lösungsansätze: In der richtigen Reihenfolge vorgehen
1. Zuerst die Verluste sichtbar machen
Über acht bis zwölf Wochen wird je Anlage erfasst: Zeitpunkt, Dauer, Störungscode, betroffene Baugruppe. Vier Felder. Erfasst wird von der Schicht, nicht von der Instandhaltung.
2. Kurze Codelisten je Anlage einführen
Zehn bis fünfzehn Codes pro Anlage, gemeinsam mit den Maschinenführern erarbeitet und an der Anlage sichtbar. Werden die Codes im Büro erfunden, werden sie im Betrieb nicht verwendet.
3. Kurzstillstände mit erfassen
Auch Stopps unter fünf Minuten – gerade diese. Sie sind der Teil, der in der Wahrnehmung fehlt und in der Auswertung dominiert.
4. Nach Stillstandszeit auswerten, nicht nach Häufigkeit
Die Priorität ergibt sich aus der Summe der Stillstandszeit je Störungsart, nicht aus der Anzahl der Einträge. In der Regel zeigt sich eine deutliche Konzentration auf wenige Störungsarten.
5. Die Kennzahlen sauber definieren
Verfügbarkeit, mittlere Betriebsdauer zwischen Ausfällen und mittlere Reparaturdauer sind in Normen und Richtlinien definiert – etwa in DIN EN 13306 zu den Begriffen der Instandhaltung und in VDI 2893 zur Bildung von Instandhaltungskennzahlen. Eine gemeinsame Definition verhindert, dass später über Zahlen statt über Ursachen diskutiert wird.
6. Mit autonomer Instandhaltung beginnen
Reinigen, Prüfen, Schmieren und Nachstellen durch die Bedienenden selbst, mit kurzen bildbasierten Standards und festen Zeitfenstern. Dieses Vorgehen ist als Bestandteil der Total Productive Maintenance beschrieben und wirkt in der Regel innerhalb weniger Monate – ohne Sensorik und ohne Modell.
7. Zustandsüberwachung dort, wo sie sich rechnet
Wo eine Baugruppe nachweislich häufig ausfällt und ein klarer physikalischer Indikator existiert – Schwingung, Temperatur, Stromaufnahme, Druck –, ist eine Zustandsüberwachung sinnvoll. Das ist zustandsorientierte Instandhaltung und braucht kein lernendes Modell.
8. Erst danach über Vorhersage sprechen
Ein Vorhersagemodell setzt voraus: einheitlich codierte Ereignisse über einen ausreichend langen Zeitraum, eine relevante Zahl vergleichbarer Ausfälle, verfügbare Maschinen- oder Sensordaten in passender Auflösung und eine Baugruppe, bei der eine Vorwarnzeit tatsächlich nutzbar ist.
Fehlt eine dieser Bedingungen, ist das Ergebnis nicht schlecht – es ist nicht belastbar.
9. Den Nutzen vor der Investition beziffern
Vor jedem Angebot wird gerechnet: Welche Stillstandszeit verursacht die betroffene Baugruppe heute, welcher Anteil wäre durch Vorwarnung vermeidbar, welche Kosten stehen dem gegenüber. Ohne diese Rechnung ist keine Bewertung möglich.
10. Datenzugang und Rechte klären
Wer darf welche Maschinendaten auslesen, exportieren und auswerten? Diese Frage vor dem Projekt zu klären, ist deutlich günstiger als danach.
Praxisbeispiel: Ein typischer Fall aus dem Verpackungsdruck
Das folgende Beispiel ist anonymisiert und beschreibt eine typische Ausgangslage.
Eine Druckerei mit rund 85 Mitarbeitenden und drei Produktionslinien hatte im Vorjahr mehrere längere Stillstände. Ein Anbieter unterbreitete ein Angebot für ein Sensorik- und Analysepaket zur vorausschauenden Wartung.
Die Geschäftsführung entschied, zunächst den Ist-Zustand zu erheben.
Über zehn Wochen erfassten die Maschinenführer je Störung Zeitpunkt, Dauer, einen Code aus einer gemeinsam erstellten Liste und die betroffene Baugruppe.
Die Auswertung ergab drei Punkte.
Erstens: Der größte Anteil der Stillstandszeit entfiel nicht auf die seltenen langen Ausfälle, sondern auf eine hohe Zahl kurzer Stopps an der Weiterverarbeitung – überwiegend Zuführung und Auslage. Diese Stopps waren in der bisherigen Wahrnehmung nicht als Verlust geführt worden.
Zweitens: Ein erheblicher Teil dieser Stopps ließ sich auf zwei Ursachen zurückführen, von denen eine durch eine geänderte Reinigungsroutine und eine durch eine Justage abstellbar war.
Drittens: Die Anlage, für die die Sensorik angeboten war, verursachte nur einen kleineren Teil der gesamten Stillstandszeit. Zudem lagen zu wenige vergleichbare Ausfälle vor, um ein Modell trainieren zu können.
Die Druckerei führte eine autonome Instandhaltung mit kurzen bildbasierten Standards und festen Zeitfenstern ein und erfasste die Störungen dauerhaft mit Codes weiter. Für eine Baugruppe mit wiederkehrendem Lagerschaden wurde eine einfache Schwingungsüberwachung installiert.
Die Anlagenverfügbarkeit stieg messbar. Das Sensorik- und Analysepaket wurde nicht abgelehnt, sondern zurückgestellt – mit der Vereinbarung, die Entscheidung nach zwölf Monaten codierter Daten erneut zu prüfen.
Die Erkenntnis daraus: Das Angebot war fachlich nicht falsch. Es war nur auf die falsche Anlage gerichtet – und ein Jahr zu früh.
Fazit
Vorausschauende Wartung ist kein Einstiegsprojekt. Sie ist ein Ausbaustand.
Die Voraussetzung ist unspektakulär: einheitlich codierte Störungen mit Zeitpunkt, Dauer und Baugruppe, erfasst von den Menschen an der Anlage, über einen ausreichend langen Zeitraum.
Genau diese Erfassung erzeugt schon vor jedem Modell den größten Teil des Nutzens – weil sie zeigt, wo die Stillstandszeit tatsächlich entsteht. Erfahrungsgemäß ist das nicht dort, wo sie vermutet wird.
Wer mit autonomer Instandhaltung beginnt, verbessert die Verfügbarkeit in Monaten und baut dabei die Datenbasis auf, die für eine spätere Entscheidung nötig ist.
Das ist die pragmatische Reihenfolge: messen, abstellen, überwachen – und erst dann vorhersagen.
Häufige Fragen (FAQ)
Was braucht ein Modell zur Ausfallvorhersage mindestens?
Einheitlich codierte Ereignisse mit Zeitpunkt, Dauer und Baugruppenbezug über einen ausreichend langen Zeitraum, eine relevante Zahl vergleichbarer Ausfälle, verfügbare Maschinen- oder Sensordaten in passender Auflösung und eine nutzbare Vorwarnzeit.
Ist Zustandsüberwachung dasselbe wie Predictive Maintenance?
Nein. Zustandsüberwachung misst einen physikalischen Indikator gegen einen Grenzwert – das ist zustandsorientierte Instandhaltung. Vorhersage bedeutet, aus Verlaufsdaten auf einen künftigen Ausfall zu schließen.
Warum sind Kurzstillstände so wichtig?
Weil sie in der Summe häufig mehr Zeit kosten als die seltenen langen Ausfälle – und weil sie in der Wahrnehmung nicht als Verlust erscheinen.
Wie viele Störungscodes sind sinnvoll?
Zehn bis fünfzehn je Anlage, gemeinsam mit den Maschinenführern erarbeitet. Längere Listen werden im Betrieb nicht genutzt.
Was ist autonome Instandhaltung?
Reinigen, Prüfen, Schmieren und einfaches Nachstellen durch die Bedienenden selbst, auf Basis kurzer Standards und in festen Zeitfenstern. Sie ist Bestandteil der Total Productive Maintenance.
Sollte man ein Angebot zur vorausschauenden Wartung ablehnen?
Nicht grundsätzlich. Sinnvoll ist, es an einer Rechnung zu prüfen: Welche Stillstandszeit verursacht die betroffene Baugruppe heute, und welcher Anteil wäre durch Vorwarnung vermeidbar?
Lassen Sie uns gemeinsam prüfen, wo Ihre Stillstandszeit entsteht
Sie möchten wissen, welche Störungsarten bei Ihnen die meiste Stillstandszeit verursachen und ob eine datenbasierte Vorhersage in Ihrem Fall tragfähig wäre? Wir unterstützen Sie gerne bei der Analyse Ihrer Instandhaltungsdaten.
Quellenverzeichnis
- DIN EN 13306: Instandhaltung – Begriffe der Instandhaltung. Berlin: Beuth Verlag. (Definitionen zu präventiver, zustandsorientierter und vorausschauender Instandhaltung)
- VDI 2893: Auswahl und Bildung von Kennzahlen für die Instandhaltung. Düsseldorf: Verein Deutscher Ingenieure (VDI).
- DIN EN 15341: Instandhaltung – Wesentliche Leistungsindikatoren für die Instandhaltung. Berlin: Beuth Verlag.
- Nakajima, Seiichi (1988): Introduction to TPM: Total Productive Maintenance. Cambridge: Productivity Press. (Autonome Instandhaltung und Anlagenverluste)
- DIN EN ISO 9001:2015: Qualitätsmanagementsysteme – Anforderungen, Abschnitt 7.1.3 (Infrastruktur). Berlin: Beuth Verlag.
Hinweise: Der Beitrag bewertet methodische Voraussetzungen und enthält keine Produkt- oder Anbieterempfehlung. Aussagen zur Verfügbarkeit und Exportierbarkeit von Maschinendaten sind anlagen- und herstellerabhängig und im Einzelfall zu klären. Das Praxisbeispiel ist anonymisiert und beschreibt eine typische Ausgangslage; die genannten Größenangaben dienen der Veranschaulichung.